Thời gian gần đây, tôi thường thấy một câu hỏi trong các cộng đồng AI: “Vì sao mới prompt một, hai lần đã hết token?” Có người chỉ hỏi đáp đơn giản. Có người làm việc với Claude Code hoặc một AI Agent được vài lượt thì hệ thống báo sắp chạm giới hạn.
Nguyên nhân thường không nằm ở một câu prompt riêng lẻ. Token bị tiêu tốn nhanh chủ yếu do ba thói quen: dùng model và mức effort quá cao cho mọi việc, giữ quá nhiều task trong cùng một session, hoặc đưa tài liệu dài vào khi AI chỉ cần một phần nhỏ.
Bài viết này tập trung vào ba vấn đề đó và cách xử lý ngay trước khi bạn giao việc cho AI.
Trước tiên, “hết Token” có thể mang nhiều nghĩa
Token là đơn vị model dùng để xử lý đầu vào và tạo đầu ra. Một yêu cầu có thể gồm input token, output token, token được lưu trong bộ nhớ đệm và reasoning token dùng cho quá trình suy luận.
Trong các cuộc thảo luận, “hết token” thường được dùng để mô tả ba tình huống khác nhau:
- Tài khoản chạm hạn mức sử dụng của gói chat.
- Session chạm giới hạn Context Window nên phải rút gọn hoặc loại bỏ bớt lịch sử.
- Người dùng API tiêu hết credit hoặc thấy chi phí tăng nhanh.
Ba tình huống này liên quan đến token nhưng không hoàn toàn giống nhau. Mở session mới có thể giảm phần lịch sử AI phải xử lý, nhưng không làm hạn mức của tài khoản được đặt lại. Đổi sang model nhẹ hơn có thể giúp dùng hạn mức lâu hơn, nhưng không làm một tài liệu dài tự động ngắn đi.
Vì vậy, trước khi tối ưu, bạn cần biết bản thân đang gặp vấn đề nào. Sau đó mới kiểm tra ba nguyên nhân dưới đây.
1. Dùng Model và Effort quá cao cho mọi Task
Không phải việc nào cũng cần model mạnh nhất và mức suy luận cao nhất. Nếu bạn dùng cùng một cấu hình cho cả việc xây chiến lược lẫn sửa một câu email, phần tài nguyên dành cho những task đơn giản có thể lớn hơn mức cần thiết.
Model và effort ảnh hưởng đến token theo hai cách khác nhau.
Thứ nhất, mỗi model có mức giá, khả năng và hạn mức sử dụng khác nhau. Cùng một lượng token đầu vào không có nghĩa chi phí hoặc tốc độ tiêu hao hạn mức sẽ giống nhau. Chẳng hạn, trong hệ Claude, dòng Opus và Sonnet được định giá khác nhau; mức giá cụ thể thay đổi theo phiên bản và loại model.
Thứ hai, mức effort quyết định model dành bao nhiêu công sức cho việc suy luận. Effort cao hữu ích khi task có nhiều điều kiện, cần cân nhắc rủi ro hoặc phải lập luận qua nhiều bước. Nhưng với việc hỏi đáp, định dạng hay chỉnh sửa đơn giản, phần suy luận bổ sung có thể không tạo ra giá trị tương xứng. Anthropic cũng hướng dẫn rằng giảm effort có thể giảm lượng thinking và token sử dụng.
Cách chọn trước khi giao việc
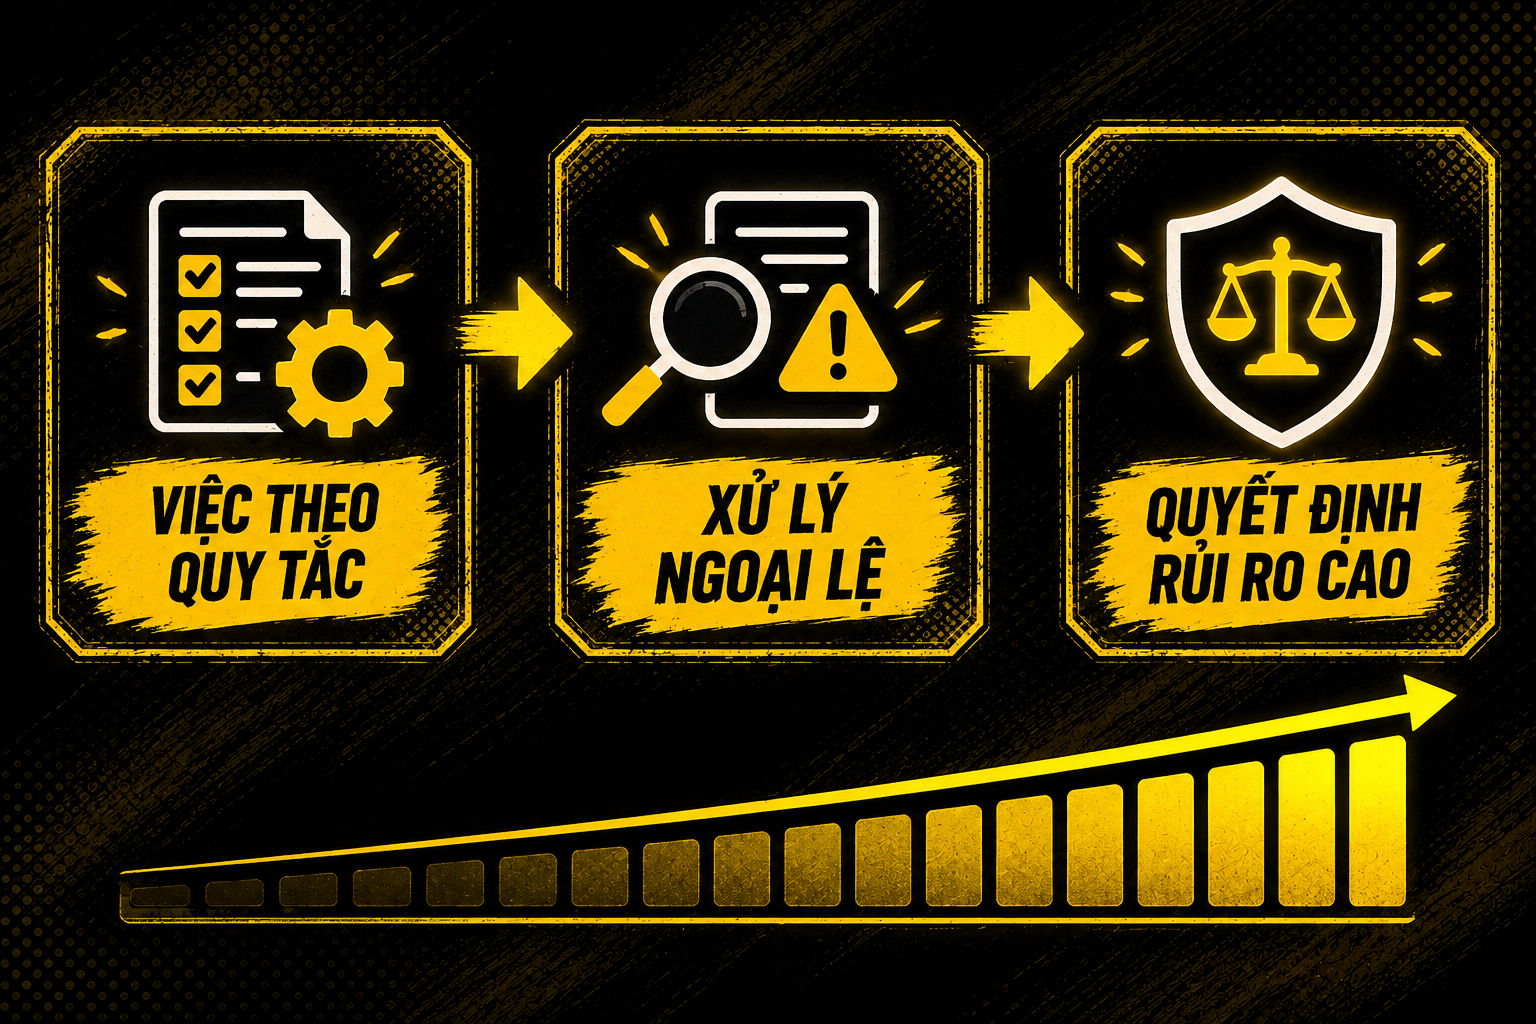
Bạn có thể chia công việc thành hai nhóm đơn giản:
- Task cần suy luận: xây chiến lược, phân tích nhiều nguồn, tìm nguyên nhân lỗi, đánh giá rủi ro hoặc đưa ra quyết định khó. Đây là lúc model mạnh và effort cao có thể hữu ích.
- Task thực thi rõ ràng: sửa câu, đổi định dạng, trích thông tin, tóm tắt ngắn hoặc trả lời một câu hỏi đơn giản. Hãy bắt đầu bằng model nhẹ hơn và effort thấp hơn.
Ví dụ, bạn không cần dùng Claude Opus với effort cao chỉ để chuyển một danh sách thành bảng. Sonnet hoặc một model nhẹ hơn có thể xử lý tốt nếu yêu cầu đã rõ. Ngược lại, khi cần phân tích một kế hoạch có nhiều ràng buộc và chỉ ra rủi ro, hạ model chỉ để tiết kiệm có thể khiến bạn mất thêm thời gian kiểm tra và sửa kết quả.
Nguyên tắc thực tế là: bắt đầu bằng cấu hình vừa đủ, chỉ nâng model hoặc effort khi độ khó của task yêu cầu. Đừng chọn model mạnh nhất theo thói quen.
2. Dùng một Session cho nhiều Task khác nhau
Session càng dài, lượng lịch sử cần được duy trì trong context càng lớn. Đây là lý do một cuộc trò chuyện ban đầu chạy tốt nhưng về sau có thể trở nên nặng hoặc khiến AI bám nhầm yêu cầu cũ.
Context Window là lượng thông tin model có thể sử dụng trong một lần xử lý. Nó không chỉ chứa prompt bạn vừa nhập. Tùy ứng dụng, context còn có thể gồm chỉ dẫn hệ thống, lịch sử trao đổi, nội dung file, kết quả từ công cụ và phần AI đã trả lời trước đó.
Ứng dụng không nhất thiết gửi lại nguyên văn toàn bộ session trong mọi trường hợp. Một số hệ thống có thể dùng bộ nhớ đệm, tìm phần liên quan, tự tóm tắt hoặc loại bỏ nội dung cũ. Nhưng về nguyên tắc, muốn AI tiếp tục một cuộc trò chuyện, ứng dụng vẫn phải giữ lại đủ lịch sử để model hiểu những gì đã xảy ra.
Khi lượng thông tin vượt giới hạn, hệ thống có thể cắt bớt các message cũ. Với Coding Agent, thao tác compact cũng nhằm nén lịch sử thành một bản tóm tắt để tiếp tục làm việc trong context còn lại.
Khi nào tiếp tục, compact hoặc mở Session mới?
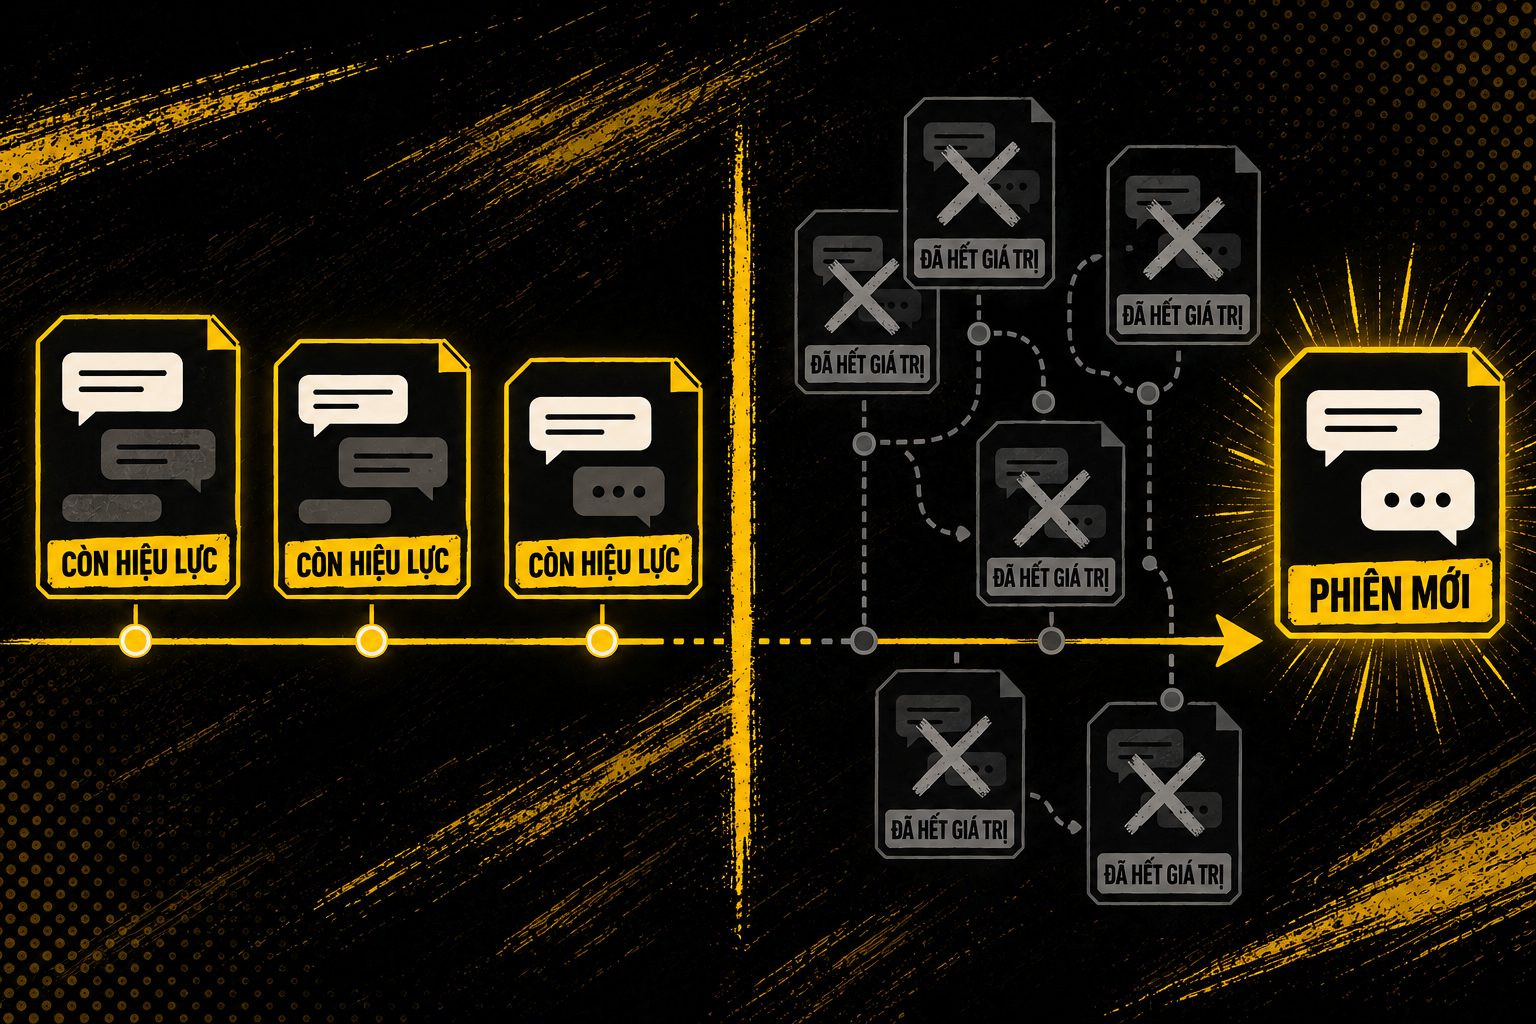
Tiếp tục session hiện tại khi bạn vẫn đang làm cùng một task và các quyết định trước đó còn cần thiết. Ví dụ, bạn đang lần lượt sửa phần mở bài, thân bài và kết luận của cùng một bài viết.
Compact hoặc tạo bản bàn giao khi task chưa xong nhưng session đã có nhiều vòng thử sai. Bản bàn giao nên giữ lại mục tiêu, quyết định đã chốt, nguồn đang dùng, phần chưa hoàn thành và bước tiếp theo. Bạn cần đọc lại bản tóm tắt vì quá trình nén có thể bỏ sót một chi tiết quan trọng.
Mở session mới khi bạn chuyển sang một task khác. Viết email từ một báo cáo là một đầu việc mới; hãy mang sang kết luận cần dùng thay vì kéo theo toàn bộ quá trình tạo báo cáo. Tương tự, không nên dùng một session chung cho nghiên cứu, viết bài, sửa code và hỏi đáp chỉ vì các việc đó cùng thuộc một dự án.
Một cách kiểm tra nhanh là nhìn vào prompt bạn sắp gửi. Nếu bạn phải viết “bỏ qua yêu cầu trước”, “không làm theo phương án cũ” hoặc “bây giờ chuyển sang việc khác”, đó thường là lúc nên mở session mới.
3. Đưa tài liệu quá dài hoặc quá nhiều File vào Context
File đính kèm cũng có thể làm tăng lượng thông tin AI phải xử lý. Một bản PDF dài, file PowerPoint nhiều slide, tài liệu có nhiều phiên bản hoặc cả thư mục dự án đều có thể chứa phần không liên quan đến câu hỏi hiện tại.
Cách ứng dụng xử lý file không giống nhau. Có hệ thống trích xuất nội dung, có hệ thống chia tài liệu thành từng đoạn rồi tìm phần liên quan, và có công cụ cho model đọc file trong quá trình thực hiện task. Vì vậy, không nên khẳng định AI luôn đọc toàn bộ file ở mỗi lượt.
Điều bạn có thể kiểm soát là phạm vi tài liệu được giao.
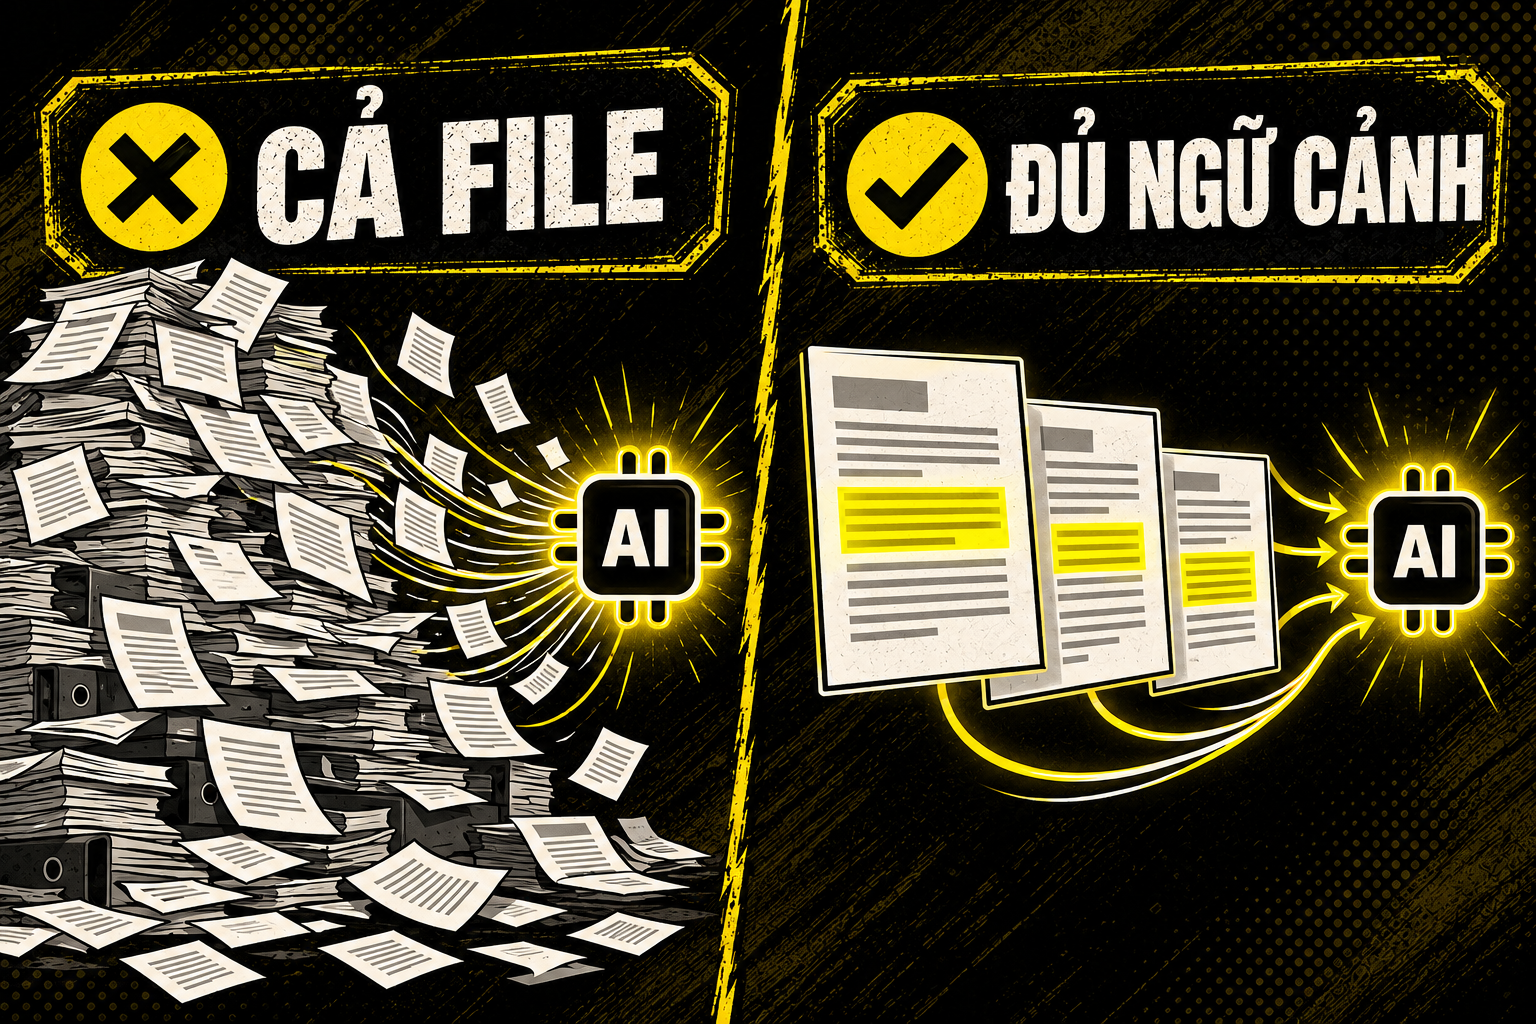
Ví dụ, bạn cần kiểm tra điều khoản thanh toán nằm ở trang 18 của một hợp đồng. Nếu chỉ gửi cả file rồi yêu cầu “hãy phân tích tài liệu này”, AI phải tự xác định bạn cần gì và có thể trả về nhiều nội dung không liên quan. Yêu cầu rõ hơn sẽ là: “Đọc mục Thanh toán ở trang 18–20, xác định thời hạn, điều kiện phát sinh phí và những điểm cần xác nhận lại.”
Cách gửi tài liệu vừa đủ
Trước khi đính kèm file, hãy làm rõ ba điều:
- AI cần trả lời câu hỏi nào?
- Thông tin có khả năng nằm ở file, phần hoặc trang nào?
- AI cần đọc thêm phần nào để hiểu đúng ngữ cảnh?
Nếu biết vị trí, hãy chỉ rõ chương, mục hoặc số trang cần đọc. Với nhiều file, nên cung cấp một danh mục ngắn gồm tên tài liệu, phiên bản và vai trò của từng file. Nếu có bản cũ và bản mới, hãy nói rõ bản nào đang có hiệu lực.
Nếu chưa biết thông tin nằm ở đâu, bạn có thể chia thành hai lượt. Lượt đầu yêu cầu AI xác định các phần liên quan. Lượt sau chỉ phân tích kỹ những phần đã chọn.
Không nên cắt tài liệu bằng mọi giá. Một điều khoản có thể phụ thuộc vào định nghĩa ở đầu văn bản hoặc ngoại lệ ở phần sau. Khi độ chính xác quan trọng, hãy giữ đủ phần liên quan để AI hiểu và chỉ ra căn cứ đã sử dụng. Mục tiêu là bỏ phần không phục vụ task, không phải tạo đầu vào ngắn nhất.
Kết luận
Muốn tối ưu token thì bạn chỉ cần nhớ trước khi giao task hãy kiểm tra ba điều: task này cần model và mức effort nào, có nên tiếp tục trong session hiện tại không, và AI thực sự cần đọc bao nhiêu tài liệu. Chỉ ba thay đổi đó đã giúp bạn tránh dùng model mạnh cho việc đơn giản, mang lịch sử không liên quan sang task mới hoặc bắt AI xử lý cả một file khi chỉ cần vài trang.
Cách tối ưu tốt không phải là dùng ít token nhất, mà là dùng token cho đúng thông tin và đúng mức độ xử lý mà công việc cần.